アーキテクチャ
Geminiとのインテグレーションはサーバー側で動作します。
ブラウザがGeminiへ直接接続することはありません。
そのため、Google API Keyがクライアント側へ渡ることもありません。
処理の流れはシンプルです。
ユーザー
   │
   │ マイク音声
   ▼
Browser
   │
   ▼
Agora RTC
   │
   ▼
Gemini 3.5 Transcribe
   │
   │ Transcript
   ▼
LLM
   │
   │ Response
   ▼
TTS
   │
   ▼
Agora RTC
   │
   ▼
ユーザー
ブラウザからマイク音声をAgora RTCへPublishします。
Agoraはその音声をGemini 3.5 Transcribeへ渡し、文字起こし結果をLLMへの入力として利用します。
LLMが生成した回答はTTSへ送信され、生成された音声がAgora RTCを経由してユーザーへ返されます。
一方で、RTM(Real-Time Messaging)は別のデータパスとして利用されます。
RTMでは、
- Transcript
- Agent State
- Metrics
- Error
などのアプリケーションイベントを扱います。
簡単に整理すると、
RTC → 音声
RTM → アプリケーションイベント
という役割分担です。
SDKをインストールする
Node.jsまたはNext.jsサーバーへAgora Agents SDKをインストールします。
npm install agora-agents
ブラウザ側でRTC音声、RTMイベント、Agent Client Toolkitを利用する場合は、以下をインストールします。
npm install agora-rtc-react agora-rtc-sdk-ng agora-rtm agora-agent-client-toolkit agora-token
[!NOTE]
AI Agentの作成処理はサーバー側に置いてください。
特に以下の情報をブラウザBundleへ含めないように注意してください。
- Agora App Certificate
- Google API Key
環境変数を設定する
Next.jsの場合、たとえば以下の環境変数を利用できます。
NEXT_PUBLIC_AGORA_APP_ID=your_agora_app_id
NEXT_AGORA_APP_CERTIFICATE=your_agora_app_certificate
GOOGLE_API_KEY=your_google_api_key
NEXT_PUBLIC_AGENT_UID=123456
Agora App IDについてはブラウザ側へ公開しても問題ありません。
一方で、
NEXT_AGORA_APP_CERTIFICATE
GOOGLE_API_KEY
はサーバー専用の値です。
これらのSecretにはNEXT_PUBLIC_を付けないでください。
NEXT_PUBLIC_AGENT_UIDはRTC Channel内でAI Agentを識別するためのUIDです。
ブラウザ側では、このUIDを使って人間のParticipantとAI Agentを区別します。
そのため、ClientとServerで同じAgent UIDを使用する必要があります。
Agent Pipelineを作成する
次のTypeScriptサンプルでは、
- Gemini 3.5 Transcribe:STT
- Gemini:LLM
- Google TTS:音声出力
という構成でAgentを作成します。
import {
  Agent,
  AgoraClient,
  Area,
  ExpiresIn,
  GeminiTranscribeSTT,
  Gemini,
  GoogleTTS,
} from 'agora-agents';

function requireEnv(name: string): string {
  const value = process.env[name];

  if (!value) {
    throw new Error(`Missing environment variable: ${name}`);
  }

  return value;
}

const appId = requireEnv('NEXT_PUBLIC_AGORA_APP_ID');
const appCertificate = requireEnv('NEXT_AGORA_APP_CERTIFICATE');
const googleApiKey = requireEnv('GOOGLE_API_KEY');

const client = new AgoraClient({
  area: Area.US,
  appId,
  appCertificate,
});

const greeting = 'Hello! How can I help?';

const agent = new Agent({
  client,
  instructions: 'You are a concise and helpful voice assistant.',
  greeting,
  failureMessage: 'Please wait a moment.',
  maxHistory: 50,

  turnDetection: {
    config: {
      speech_threshold: 0.5,

      start_of_speech: {
        mode: 'vad',
        vad_config: {
          interrupt_duration_ms: 160,
          prefix_padding_ms: 300,
        },
      },

      end_of_speech: {
        mode: 'vad',
        vad_config: {
          silence_duration_ms: 480,
        },
      },
    },
  },

  advancedFeatures: {
    enable_rtm: true,
  },

  parameters: {
    data_channel: 'rtm',
    enable_error_message: true,
    enable_metrics: true,
  },
})
  .withStt(
    new GeminiTranscribeSTT({
      apiKey: googleApiKey,
      model: 'models/gemini-3.5-transcribe-live',
    }),
  )
  .withLlm(
    new Gemini({
      apiKey: googleApiKey,
      model: 'gemini-3.6-flash',
      systemMessages: [
        {
          parts: [
            {
              text: 'You are a concise and helpful voice assistant.',
            },
          ],
          role: 'user',
        },
      ],
      greetingMessage: greeting,
      failureMessage: 'Please wait a moment.',
      maxHistory: 15,
    }),
  )
  .withTts(
    new GoogleTTS({
      key: googleTtsCredentials,
      voiceName: 'en-US-Chirp3-HD-Charon',
    }),
  );

export async function startAgent(
  channelName: string,
  requesterUid: string,
): Promise<string> {
  const session = agent.createSession({
    name: `gemini-transcribe-${Date.now()}`,
    channel: channelName,
    agentUid: process.env.NEXT_PUBLIC_AGENT_UID ?? '123456',
    remoteUids: [requesterUid],
    idleTimeout: 30,
    expiresIn: ExpiresIn.hours(1),
    debug: false,
  });

  return await session.start();
}
AgoraClientは、App IDとApp Certificateを使用してConversational AIのLifecycle APIを認証します。
const client = new AgoraClient({
  area: Area.US,
  appId,
  appCertificate,
});
Agent.createSession()では、Agent用のRTC Tokenを生成し、RTC Channelへ参加するためのリクエストを作成します。
const session = agent.createSession(...)
そして、
session.start()
を実行すると、Runtime Agent IDが返されます。
アプリケーション側で後からAgentを停止したりSessionを確認したりする場合は、このAgent IDを保存しておきましょう。
remoteUidsについて
remoteUidsは、AI AgentがどのRTCユーザーの音声をListenするかを指定します。
本番環境では、
remoteUids: [requesterUid]
のように特定ユーザーを指定します。
一方、開発時にChannel内のすべてのユーザーを対象にしたい場合は、
remoteUids: ['*']
とすることもできます。
ただし、['*']を指定するとAgentはChannel内のすべてのユーザーをSubscribeします。
そのため、本番環境では基本的に対象となるParticipantのみを指定することを推奨します。
Gemini 3.5 Transcribeを設定する
リアルタイム文字起こしに使用するモデルは以下です。
models/gemini-3.5-transcribe-live
Gemini 3.5 Transcribeでは、言語を指定することもできます。
例えばスペイン語の場合、
language_codes=["es-ES"]
のように指定します。
一方で、
- Automatic Language Identification
- Multilingual Transcription
- Code-Switching Detection
を有効にしたい場合は、language_codes自体を省略するか、空の配列を渡します。
language_codes=[]
これはVoice AI Agentでは特に便利です。
実際のサービスでは、通話が始まる前にユーザーがどの言語を話すのか分からないケースも多いためです。
例えば、
日本語 → 英語 → 日本語
のように会話途中で言語が切り替わるケースにも対応しやすくなります。
custom_vocabularyを利用する
Gemini APIには、
custom_vocabulary
も用意されています。
これを利用すると、特定の単語を優先的に認識するようSpeech Recognitionを調整できます。
例えば、
- 会社名
- 製品名
- 略語
- 技術用語
- 業界固有の専門用語
などです。
通常のSpeech Recognitionでは認識しづらい固有名詞が多いサービスで特に役立ちます。
Server RouteからAgentを起動する
BrowserはまずServerへリクエストを送り、
- Channel Name
- RTC + RTM Token
を取得します。
その後、取得したChannelとUIDをProtected Agent Start Routeへ送信します。
Next.jsの場合は、例えば以下のように実装できます。
export async function POST(request: Request) {
  const body = await request.json();
  const { channel_name, requester_id } = body;

  if (!channel_name || !requester_id) {
    return Response.json(
      {
        error: 'channel_name and requester_id are required',
      },
      {
        status: 400,
      },
    );
  }

  const agentId = await startAgent(
    channel_name,
    requester_id,
  );

  return Response.json({
    agent_id: agentId,
    state: 'STARTING',
  });
}
ここで重要なのは、Start Requestが成功したからといって、AgentがすでにRTC ChannelへJoinしたとは限らないという点です。
ブラウザ側では、設定したAgent UIDに対するRTCの
user-joined
イベントを待ってから、Agent Audioを期待するようにしてください。
本番環境では、このRouteに対して以下の対策も必要です。
- Route Authentication
- Channelへのアクセス権限チェック
- RTC UID Validation
- Agent CreationのRate Limit
- Unique Agent Nameの生成
BrowserをRTCとRTMへ接続する
Browser側には主に3つの役割があります。
- RTCへJoinしてMicrophoneをPublishする
- RTMへ接続する
- AgoraVoiceAIを初期化する
1. RTCへJoinしてMicrophoneをPublishする
Agora React SDKを利用する場合は、以下のようにRTC Channelへ参加できます。
const { isConnected } = useJoin(
  {
    appid: process.env.NEXT_PUBLIC_AGORA_APP_ID!,
    channel,
    token,
    uid: Number(uid),
  },
  isReady,
);

const { localMicrophoneTrack } =
  useLocalMicrophoneTrack(isReady);

usePublish([localMicrophoneTrack]);
useJoin()でRTC Channelへ参加し、
useLocalMicrophoneTrack()
でMicrophone Trackを作成します。
その後、
usePublish([localMicrophoneTrack])
でマイク音声をChannelへPublishします。
2. RTMへ接続する
次にRTMへLoginします。
Tokenを生成したときと**同じIdentity(UID)**を利用してください。
さらにRTCと同じChannelをSubscribeします。
const rtm = new AgoraRTM.RTM(appId, uid);

await rtm.login({ token });
await rtm.subscribe(channel);
RTCとRTMで異なるUIDを使わないように注意してください。
3. AgoraVoiceAIを初期化する
RTCへ正常にJoinしたら、Agent Client Toolkitを初期化します。
const ai = await AgoraVoiceAI.init({
  rtcEngine: rtcClient,
  rtmConfig: {
    rtmEngine: rtm,
  },
  renderMode: TranscriptHelperMode.TEXT,
});

ai.subscribeMessage(channel);

ai.on(
  AgoraVoiceAIEvents.TRANSCRIPT_UPDATED,
  (transcript) => {
    setTranscript([...transcript]);
  },
);

ai.on(
  AgoraVoiceAIEvents.AGENT_METRICS,
  (_agentUid, metrics) => {
    setLatestMetrics(metrics);
  },
);
このToolkitは、RTMから送られてくるPayloadを、
- Transcript
- Agent State
- Metrics
- Error
などの扱いやすいイベントへ変換してくれます。
例えば、
AgoraVoiceAIEvents.TRANSCRIPT_UPDATED
を利用すれば、リアルタイムでTranscriptを画面へ表示できます。
また、
AgoraVoiceAIEvents.AGENT_METRICS
を使えば、Agentに関連するMetricsも取得できます。
RTC + RTM権限を持つTokenを生成する
RTMを利用する場合、TokenにはRTM Privilegeも必要です。
RTC専用Token Builderではなく、
RtcTokenBuilder.buildTokenWithRtm
を使用します。
import {
  RtcRole,
  RtcTokenBuilder,
} from 'agora-token';

const token = RtcTokenBuilder.buildTokenWithRtm(
  appId,
  appCertificate,
  channel,
  uid.toString(),
  RtcRole.PUBLISHER,
  expirationTime,
  expirationTime,
);
ここで重要なのがUIDです。
以下の3つはすべて一致している必要があります。
RTC UID
RTM Login UID
Token Subject
また、RTM ClientもRTCおよびAgent Sessionと同じChannelをSubscribeする必要があります。
Agentを正しく停止する
Agentを停止するには、Server側でAgentSessionオブジェクトを保持しておきます。
停止する際は、
await session.stop();
を実行します。
Agentの停止をRequestした後は、
- BrowserをRTMからLogout
- RTC Conversation ViewをUnmount
します。
Agora React Hooksを利用している場合は、
- Leave
- Unpublish
- Microphone Track Cleanup
などはHooks側へ任せるのがおすすめです。
Hooksがすでに管理しているResourceを手動でCloseすると、二重Cleanupなどの問題が発生する可能性があります。
トラブルシューティング
Agentは起動するがユーザーの音声を聞けない
まず、Browserが有効なMicrophone TrackをPublishしているか確認してください。
さらに、
remoteUids
にBrowser側の実際のRTC UIDが文字列として含まれているか確認します。
例えば、
remoteUids: [requesterUid]
です。
音声は動くがTranscriptやMetricsが取得できない
この場合はRTM全体の流れを確認します。
まずTokenに、
- RTC Privilege
- RTM Privilege
の両方が含まれている必要があります。
RTM Clientについても、Token生成時と同じUIDでLoginしてください。
そしてRTCと同じChannelをSubscribeします。
Agent側ではRTMを有効化する必要があります。
advancedFeatures: {
  enable_rtm: true,
}
さらにData ChannelとしてRTMを指定します。
parameters: {
  data_channel: 'rtm',
}
Metricsを取得したい場合は、
enable_metrics: true
も有効にしてください。
Start APIは成功するがAgentの音声が来ない
Lifecycle APIから成功Responseが返ってきても、
AgentがRTCへJoin済み
とは限りません。
設定したAgent UIDがRTC Channelへ表示されるまで待ってください。
つまりBrowser側では、
user-joined
を確認してからAgentとの会話を開始します。
RTMでinvalid-tokenエラーが出る
Server側で、
buildTokenWithRtm
を利用しているか確認してください。
また、
RTM Loginに渡したUID
と、
Token Subject
が完全に一致しているか確認してください。
本番環境向けチェックリスト
Productionへリリースする前に、以下を確認しておきましょう。
- Google API KeyをServer Sideだけで管理する
- Agora App CertificateをServer Sideだけで管理する
- Token RouteをAuthenticationする
- Agent Start RouteをAuthenticationする
- Agent Stop RouteをAuthenticationする
- 各RouteへRate Limitを設定する
- Runtime Agent IDをアプリケーションユーザーと紐付ける
- Agent Nameを毎回Uniqueに生成する
- RTC Tokenを期限前にRenewする
- RTM Tokenを期限前にRenewする
- RTM PayloadをUntrusted Inputとして扱う
- ProductionではVerbose SDK Loggingを無効にする
- STT Latencyを計測する
- LLM Latencyを計測する
- TTS Latencyを計測する
特に、
STT
LLM
TTS
のLatencyはまとめて計測するのではなく、それぞれ個別に計測することをおすすめします。
そうすることで、Speech Recognition、Reasoning Model、TTS Providerなどを切り替えた際に、
「どのStageでLatencyが増えたのか?」
を簡単に確認できます。
Smart Transcriptionへの対応も予定
Gemini 3.5 Transcribeでは、input_audio_transcription内へ新しくmodeパラメータが追加されました。
現在、2つのTranscription Modeがあります。
VERBATIM
SMART
VERBATIM
VERBATIMはDefault Modeです。
話された内容をできるだけそのまま保持します。
例えば、
- Filler Words
- Repetition
- False Starts
- Self-Correction
なども残ります。
つまり、
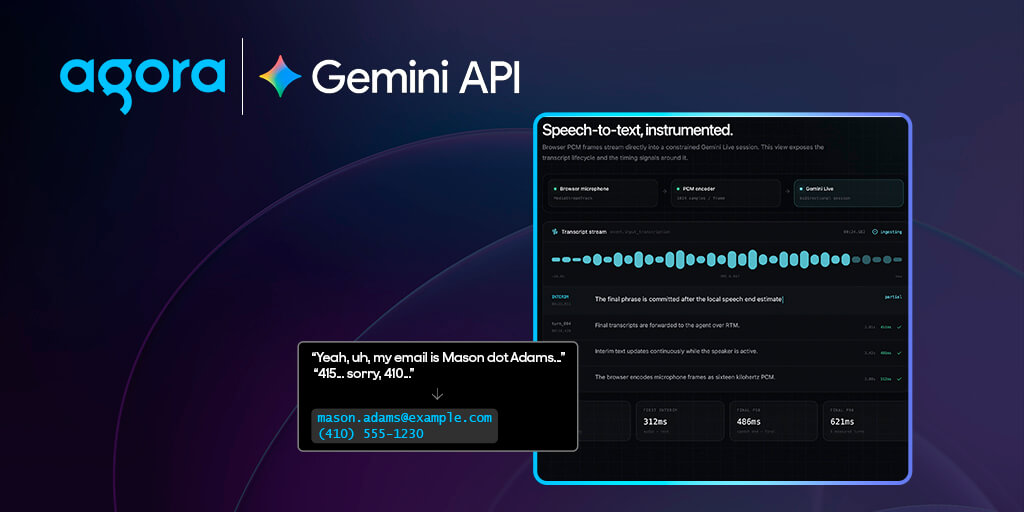
「えーっと、電話番号は415……あ、ごめんなさい、410……」
のような話し方も、そのままTranscriptへ反映されます。
SMART
一方、SMARTはTranscriptをリアルタイムで整理します。
例えば、
- Disfluencyの除去
- 言い直しの解決
- Grammarの改善
- 大文字・小文字の整理
- Number Formatting
- Date Formatting
- List Formatting
- Paragraph Break
などを自動的に行います。
例えばユーザーが、
My number is four one five, uh sorry, four one zero, five five five, twelve thirty.
と話したとします。
VERBATIMでは、
415 → 言い直し → 410
という情報もそのまま保持されます。
一方Smart Transcriptionでは、False Startを解決して、最終的にユーザーが意図した正しい情報を生成できます。
なぜSmart TranscriptionがVoice AIで重要なのか?
人間同士の会話では、
「あ、違った」
「えーっと」
「いや、こっちです」
といった発話があっても、文脈から自然に理解できます。
しかしVoice AIの場合、Transcriptはそのまま、
- Tool
- CRM
- Phone Number Field
- Email Address
- Scheduling System
- Database
- API
などへ渡される可能性があります。
こうしたシステムは、人間ほどConversation Ambiguityに強くありません。
例えば、
「電話番号は415……すみません410です」
という音声から、
415
がCRMへ保存されてしまえば、Voice Agentが会話の意味を理解していても最終的なTaskは失敗します。
そのため、SMART TranscriptionはProduction Voice AIで非常に重要な機能になり得ます。
RESTful APIからSMARTを利用する
AgoraのRESTful APIを利用する場合、Gemini APIではSmart Transcriptionを以下のように指定できます。
{
  "setup": {
    "model": "models/gemini-3.5-transcribe-live",
    "generationConfig": {
      "responseModalities": ["TEXT"]
    },
    "inputAudioTranscription": {
      "mode": "SMART"
    }
  }
}
ポイントは、
"inputAudioTranscription": {
  "mode": "SMART"
}
です。
これによってSmart Transcription Modeを有効にできます。
Agora Agents SDKでのSMART対応について
現在、GeminiTranscribeSTTからSmart Transcriptionを設定するAgora Agents SDK対応も進められています。
SDK側の対応が追加されれば、RESTful APIだけでなくAgora Agents SDKからも簡単にSMART Modeを指定できるようになります。
対応後、設定方法についてもアップデートされる予定です。
まとめ
今回は、Google Gemini 3.5 TranscribeとAgora Conversational AIを組み合わせてリアルタイム音声AIエージェントを構築する方法を紹介しました。
Agora Conversational AIでは、
ユーザー音声
↓
Gemini 3.5 Transcribe
↓
LLM
↓
TTS
↓
ユーザー
というVoice AI PipelineをRTC Session内で構築できます。
さらに、
RTC → 音声
RTM → Transcript / State / Metrics / Error
と役割を分けることで、リアルタイム音声とアプリケーションデータの両方を扱えます。
特にGemini 3.5 Transcribeでは、
- リアルタイムSpeech-to-Text
- Multilingual Transcription
- Automatic Language Identification
- Code-Switching
- Custom Vocabulary
- Smart Transcription
など、Voice AIで重要となる機能が提供されています。
またAgora側ではSTT、LLM、TTSを特定Providerへ固定する必要がないため、サービスの要件に応じてAI Stackを柔軟に組み替えることができます。
Voice Agent、AIカスタマーサポート、AI受付、多言語アシスタントなどを開発している方は、ぜひ試してみてください。
参考リンク
Agora Conversational AI
https://www.agora.io/en/products/conversational-ai-engine/
Gemini 3.5 Transcribe × Agora 元記事
https://www.agora.io/en/blog/using-gemini-3-5-transcribe-with-agora-conversational-ai/
Agora Documentation
https://docs.agora.io/